quinta-feira, 2 de janeiro de 2014

Problema em Conversor Chaveado: Indutor e Validação de Projeto!

     Olá. Alguns meses atrás eu fiz um post contando um caso sobre problemas em circuitos eletrônicos devido ao excesso de fluxo de solda na placa. Hoje eu volto para, novamente, contar um caso que acompanhei na empresa na qual trabalho, em um circuito de sensor de inclinação. Como no momento estou trabalhando na parte de qualidade de produto, terei muitas histórias técnicas para contar, então pode ser que esse modelo de "estudo de caso" se torne mais comum no blog.

     Basicamente ocorreu o seguinte. Foi feita uma alteração na placa desse sensor de inclinação. O circuito em si não foi alterado. A alteração se limitou ao lay-out dos componentes, para a placa ficar menor e melhor organizada. Como o circuito era o mesmo, a nova versão de placa não foi testada pelo setor de projetos e passou direto para a produção. Então dois colegas meus, muito observadores, perceberam que o sensor ficou um pouco menos estável. Enquanto na versão antiga o ângulo possuía uma variação de 0,2° na versão nova a variação chegava a 0,7°, porém o problema parecia um pouco intermitente.

     Então teve um período de discussão se aquilo era um problema ou se era algo da nossa cabeça, foram feitas algumas comparações entre versões de placa, diversos testes. Enfim, passado esse período, determinamos que era um problema e passamos a buscar a causa. Minha ideia era desconectar o conversor chaveado e ligar uma fonte linear no lugar, para ver se a variação diminuía (suspeitava de ruido eletromagnético). Mas como não estou mais presente na empresa em tempo integral, um colega meu (um dos que observou o problema em primeiro lugar) teve a seguinte ideia: dessoldou o indutor do conversor chaveado, soldou dois fios nele e o reconectou eletricamente no circuito, porém fisicamente longe do resto dos componentes. O resultado foi uma diminuição da variação para valores iguais a versão anterior da placa.

Conclusões

     Não é novidade que conversores e fontes chaveadas geram ruído eletromagnético e o indutor é um componente onde esse fenômeno está mais concentrado. Desse caso tiramos a lição que CIs sensíveis, e nessa categoria incluo principalmente circuitos de instrumentação e medição, podem ser afetados por ruído tanto elétrico (que pode entrar pela alimentação) quanto eletromagnético. Nesses projetos o lay-out faz a diferença. A organização da placa deixa de ser uma questão puramente estética ou de economia de espaço e se torna uma questão de funcionalidade do produto, o que não ocorre com tanta ênfase em circuitos com fontes lineares, por exemplo.

     Outra lição é adotar a política de validação de projeto e alterações antes de passá-los para a produção. Mesmo nas alterações que parecem ser irrelevantes. Se a alteração foi significante a ponto de ser feita, deve ser significante a ponto de ser validada. Isso evita uma situação onde um projeto é passado para a produção, são montadas muitas vezes centenas de peças e depois percebe-se uma não conformidade. Por isso bato na tecla da validação de projeto!

     Então as dicas que eu deixo são essas: cuidado com o lay-out em fontes ou conversores chaveados. O lay-out importa muito nesses casos. Validação de projeto é uma política importante que faz a diferença.

     Espero que este estudo de caso sirva de ajuda para alguém passando por problemas semelhantes. Qualquer dúvida, sugestão, crítica ou contribuição com alguma história que presenciou, usem os comentários, que serão respondidos o mais breve possível. Um abraço, até a próxima e continuem estudando para resolvermos problemas como esse cada vez com mais facilidade!

terça-feira, 31 de dezembro de 2013

Memórias: Definições e Organização Lógica

     Olá a todos. Depois de muito tempo sem escrever no blog, mas sempre atento aos comentários de vocês, resolvi escrever esse post sobre memória, como uma continuação de nossa série sobre eletrônica digital. Espero que entendam a falta de posts, já que o semestre foi puxado, e atualmente estou trabalhando em uma empresa na parte da manhã, auxiliando em uma pesquisa na parte da tarde e estudando a noite. Pelo menos estava antes de entrar de férias desses meus três compromissos! Então sem mais delongas vamos falar das memórias!

     Eu escolhi o tema de memórias pois, em minha recente experiência como monitor de sistemas digitais, percebi que muita gente tem dificuldades em entender o funcionamento das memórias. Então hoje eu vou tentar simplificar o entendimento desse componente tão importante.

     Vamos começar falando das definições de memórias:

     A memória é um dispositivo que guarda dados, que podem ser recuperados em um momento posterior. Existem diversos tipos de memórias, que são utilizadas para diferentes necessidades. Como exemplos temos o antigo disquete, o CD, o HD, os "pentes" de memória RAM do nosso computador, nosso flash-drive (pen-drive), entre outros. Nosso dia-a-dia está lotado de equipamento com capacidade de memória. Não falo somente dos nossos computadores e celulares, mas televisões (que conseguem guardar data e hora, ou podem ser programadas para avisar do começo de um programa), nossos aparelhos de DVD, nossos microondas.

     Existem diferentes tipos de memórias para diferentes tipos de necessidades. E esses tipos receberam denominações, que facilitam a identificação. Então vou começar com algumas definições.

     Memória Sequencial (HD, CD, DVD, Disquete): Esta memória possui acesso sequencial, ou seja, em sequência, um endereço após o outro. Se estamos no início da memória e queremos ler um dado do fim dela, temos que passar por todo o espaço intermediário. Todos os exemplos entre parênteses são mídias "rotativas", ou seja, são discos. Para ler um dado "distante" somos obrigados a rotacionar o disco, ou seja, a passar por espaços intermediários que não nos interessam. Essa rotação consome tempo e, por isso, memórias sequenciais costumam ser mais lentas. Nessas mídias, por exemplo, a velocidade de leitura está associada fisicamente a velocidade máxima possível de rotação do disco, além de outros fatores.

    Memória RAM - Random Access Memory [Memória de Acesso Aleatório] (Memória RAM do computador, flash-drive): Esta memória é o oposto da memória sequencial. O aleatório no nome não significa que a memória fica pulando caoticamente entre endereços, mas significa que se estamos no início e queremos ir para o fim, não precisamos passar pelo espaço intermediário. Basicamente, para pular entre endereços vizinhos e pular entre endereços distantes, tomamos a mesma quantidade de tempo.

     Memória Volátil (Memória RAM do computador): É a memória que, uma vez cortada a energia, a memória perde todo seu conteúdo. São memórias construídas em CIs, com transistores, embora nem todas memórias de CI sejam voláteis.

     Memória Não-Volátil (HD, CD, DVD, Disquete): São memórias que mesmo cortadas a energia, não perdem a informação, já que o processo de retenção de informação não depende de energia. No caso do HD e do Disquete são métodos magnéticos, enquanto no CD e DVD são propriedades ópticas.

     Memória de Leitura e Escrita (Memória RAM, HD, Flash-Drive): São memória que permitem, além da leitura, gravação repetidas. Ou seja, podemos gravar e ler quantas vezes quisermos. A memória possui uma limitação de ciclos de gravação, mas geralmente essa quantidade é muito alta para a aplicação da memória.

     Memória ROM - Read Only Memory [Memória Somente de Leitura] (ROM de BIOS, CD-ROM): São memórias que permitem apenas uma gravação, e depois somente leitura, ou memórias que vem gravadas de fábrica, e permitem somente leitura. Algumas memórias, como as memórias de programa de microcontroladores são chamadas de ROM, mas elas são memórias do tipo flash e podem ser regravadas inúmeras vezes. Outro engano comum é achar que memória ROM é o contrário de memória RAM. Existem memórias que são ROM e RAM ao mesmo tempo, como memórias PROM (ROM Programável, porém só podia ser escrita uma vez), além de memórias ROM mais antigas.

     Vamos analisar o diagrama lógico de uma memória a partir da imagem abaixo, e entender como ela funciona:


     Uma memória tem 3 barramentos em sua estrutura lógica, que são o barramento de dados, de endereços e de controle. O barramento de endereços escolhe um endereço dentro da memória, o barramento de dados deverá contém os dados que a gente quer colocar na memória (no caso de escrita), ou irá conter os dados que a gente quer ler da memória (no caso de leitura), e o barramento de controle serve para selecionar a memória e controlar as operações de leitura e escrita. Essa descrição, embora correta, algumas vezes não é prática para o entendimento, então vamos entender cada um dos componentes da memória por analogia, que eu considero um bom método de aprendizado.

Endereços da Memória


     Imagine a memória como sendo um cômodo com várias gavetas, como o da imagem acima. Assim cada endereço é uma gaveta. Em binário, para contar de 0 a 4 (o que consegue determinar cada uma das 5 gavetas), precisamos de 3 dígitos. Vamos determinar o seguinte:

000 - Gaveta 1 (do topo)
001 - Gaveta 2
010 - Gaveta 3
011 - Gaveta 4
100 - Gaveta 5 (abaixo)

     Dessa forma percebemos que com 3 dígitos podemos "endereçar" todas as 5 gavetas. Esse é o papel do barramento de endereços. São um conjunto de entradas da memória em que a gente coloca o sinal correspondente ao endereço que queremos. No caso da nossa "memória criado-mudo" precisaríamos somente de 3 fios como barramento de endereços. Para acessar a gaveta número 4, eu colocaria o sinal 011 nesses conjunto de fios, e com isso teria acesso a gaveta número 4.

Dados da memória

     Os dados da memória podem ser vistos como sendo o conteúdo de cada gaveta. Normalmente, cada endereço da memória contém 8 bits, que formam 1 byte. Mas é possível construir memórias que possua 16 bits (2 bytes) por endereço. É possível construir inclusive memórias com menos de 1 byte por endereço, como, por exemplo, 4 bits. Mas o comum são memórias de 8 bits.

     Para definir uma memória, utilizamos um par de números. Por exemplo, uma memória 64x8 possui 64 endereços, sendo que cada endereço contém 8 bits (1 byte). Uma memória de 128x16 possui 128 endereços de 16 bits cada. Portanto esses dois números são suficientes para caracterizar a memória, do ponte de vista de capacidade de armazenamento.

     A largura do barramento de dados é determinado pelo segundo número do par. Por exemplo, a memória de 64x8 deverá ter uma largura de 8 bits no barramento de dados. Por quê? Pois para colocar uma informação de 8 bits dentro da memória, teremos que ter 8 condutores (fios), um para cada bit. A memória de 128x16, por sua vez, deverá ter uma largura de barramento de dados de 16 bits, pelo mesmo motivo explicado anteriormente.

     O largura do barramento de endereços é determinado pelo primeiro número do par, porém não de forma tão direta quanto o barramento de dados. A memória de 64x8 possui 64 endereços e, portanto, tem uma largura de endereço de 6 bits. Por quê? Pois com 6 bits podemos formar 64 combinações, uma para cada endereço. A memória de 128x16, por sua vez, deverá ter uma largura de barramento de 7 bits, pois com 7 bits podemos formar 128 combinações, uma para cada combinação. Como chegamos nesse valor? A conta é feita da seguinte forma:

[;N = log_2(A);]

Onde:
N é a largura do barramento de endereços;
A é a quantidade de endereços da memória.

     Ou seja, a largura do barramento é o número "N", onde 2 elevado a "N" resulta no número total de endereços da memória. A memória de 128 endereços possui uma largura de barramento de 7, pois:

[;2^7 = 128;]

   A largura do barramento de controle é variável, depende do tipo da memória e do fabricante. Basicamente uma memória possui uma entrada de ENABLE, que habilita a memória e, se a memória for do tipo de leitura e escrita, possuirá uma entrada de R/W, que seleciona entre o modo de leitura e escrita.

    A função do pino ENABLE, as vezes chamado de CS (Chip Select), pode variar. Geralmente coloca todas as saídas da memória (barramento de dados) em alta impedância mas, em alguns casos, pode simplesmente colocar todas as saídas da memória em 0.

     Por fim, para calcular a quantidade total de células de memória, ou seja, a quantidade total de bits que a memória consegue armazenar, apenas multiplicamos a quantidade total de endereços pelo número de bits que um endereço consegue armazenar. No caso da memória de 64x8, podemos armazenar um total de 512 bits, enquanto na memória de 128x16 podemos armazenar 2048 bits, ou 2K bits.

     E por hoje era isso. Espero ter esclarecido um pouco o conteúdo de memórias para quem precisava. Qualquer dúvida, sugestão ou crítica, deixem um comentário. Abraço a todos, boas festas de fim de ano e que tenhamos um ótimo 2014. Até a próxima e continuem estudando!

sábado, 9 de novembro de 2013

Algoritmo e Programação - If-Else Aninhados

     Olá a todos. Hoje vamos retomar a série de Algoritmo e Programação falando sobre if...else aninhados.

     Primeiro, o que são if...else aninhados? São if...elses dentro de outros if...elses e que servem para testar não somente duas condições, mas quantas condições quisermos. Vamos ver um exemplo que parte do algoritmo do último post, que pode ser visualizado clicando aqui. Este algoritmo calculava a média aritmética de três notas e exibia uma mensagem de aprovação, caso a média tivesse sido maior que 6, e de reprovação, caso a média tivesse sido menor que 6.

     Mas agora queremos fazer um upgrade neste algoritmo que, ao invés de mostrar somente mensagem de aprovação e reprovação, mostre outras mensagens, como por exemplo:

  •      "Aprovado com louvor!" - Para uma média maior ou igual a 9;
  •      "Aprovado! Parabéns!" - Para uma média maior ou igual a 8 e menor que 9;
  •      "Aprovado!" - Para uma média maior ou igual a 7, mas menor que 8;
  •      "Aprovado por pouco!" - Para uma média maior ou igual a 6, mas menor que 7;
  •      "Reprovado!" - Para uma média menor que 6;
     Então perceba que após obtermos o cálculo da média não basta fazer uma comparação, pois isto nos daria somente se a média é maior ou menor a um único valor. Temos que ser capazes de comparar com vários valores (neste caso, com 9, 8, 7 e 6) para determinarmos em qual faixa o valor da média se encontra. Como fazemos isso? Utilizamos os if...else aninhados.

///////////////////////////////////////////////////////////////////////////////////////////////


#include >stdio.h< //desinverter os símbolos de maior e menor, pois se eu escrever da maneira certa,
//o blogger entende como código HTML e "come" a expressão
#include >stdlib.h<
float nota_1 = 0, nota_2 = 0, nota_3 = 0, media = 0;

float calculo_media (float n1, float n2, float n3)
{
    float media_aritmetica;
    media_aritmetica = (n1+n2+n3)/3;
    return media_aritmetica;
}

main()
{
    printf("Digite nota 1: ");
    scanf("%f",&nota_1);
    printf("Digite nota 2: ");
    scanf("%f",&nota_2);
    printf("Digite nota 3: ");
    scanf("%f",&nota_3);
    media = calculo_media(nota_1, nota_2, nota_3);
    printf("A media calculada foi de: %f.\n",media);
    if(media < 6)
        printf("Aluno reprovado!\n\n");
    else
    {
        if( media < 7 )
            printf("Aluno aprovado por pouco!\n\n");
        else
        {
            if( media < 8 )
                printf("Aprovado!\n\n");
            else
            {
                if( media < 9 )
                    printf("Aprovado! Parabens!\n\n");
                else
                {
                    if (media ==10 )
                        printf("Aprovado com louvor!\n\n");
                }
            }
        }
    }
    system("pause");
}

     Compile este código no seu compilador e se convença do seu funcionamento. Após isto vamos discorrer um pouco sobre ele.

     Este código funciona, ele faz o que se propõe a fazer, mas ocupa muitas linhas. Utilizando de algumas propriedades da linguagem C, podemos reduzir drasticamente o numero de linhas do programa. Para testar, troque toda a função main do código anterior pela função main a seguir:

main()
{
    printf("Digite nota 1: ");
    scanf("%f",&nota_1);
    printf("Digite nota 2: ");
    scanf("%f",&nota_2);
    printf("Digite nota 3: ");
    scanf("%f",&nota_3);
    media = calculo_media(nota_1, nota_2, nota_3);
    printf("A media calculada foi de: %f.\n",media);
    if(media < 6)
        printf("Aluno reprovado!\n\n");
    else
        if( media < 7 )
            printf("Aluno aprovado por pouco!\n\n");
        else  
            if( media < 8 )
                printf("Aprovado!\n\n");
            else     
                if( media < 9)
                    printf("Aprovado! Parabens!\n\n");
                else      
                    if( media == 10)
                        printf("Aprovado com louvor!\n\n");
    system("pause");
}

     Perceba que algumas linhas foram economizadas. Isso foi possível graças ao fato de que o comando if dentro do else é apenas um comando, independente do que existe dentro do if. E sendo um comando, não precisamos utilizar as chaves, que são necessárias apenas para blocos de comandos.

     Os comando if-else aninhados permitem fazer sequências de comparações utilizando um valor, um intervalo de valor, operações lógicas, enfim, tudo que o comando if em si aceita. 

     E por hoje era isso. Agora sabemos utilizar if-else aninhados para testar quantas condições quisermos! Então continuem estudando e até a próxima na série de programação. Abraço!

domingo, 22 de setembro de 2013

Registradores Paralelo, Série, Paralelo-Série e Série-Paralelo

     Olá a todos. Continuando a série sobre eletrônica digital, hoje vou falar sobre o que são registradores, sobre a sua implementação com Flip-Flops e sobre para que eles são usados em circuitos eletrônicos.

    O que são registradores? Bom, um flip-flop isolado é um dispositivo com capacidade de armazenamento de 1 bit. Os sistemas digitais geralmente utilizam barramentos de dados com largura maior que 1 bit, como, por exemplo. 8 bits, ou 16 bits. Para armazenar as informações que circulam por este barramento um flip-flop sozinho não dá conta. Por isso se utiliza um conjunto de flip-flops em uma associação conhecida como registrador. Um registrador de 8 bits, por exemplo, é uma associação de, no mínimo, 8 flip-flops. Esta associação é capaz de armazenar 8 bits.

     Os microcontroladores Microchip PIC contém registradores de 8 bits. Como no exemplo dos PICs , registradores são ocorrências muito comuns em sistemas digitais. Mas como é possível implementar um registrador com o que a gente já conhece?

     Bom, abaixo está o esquema de um registrador paralelo de 4 bits, implementado utilizando-se FF (Flip-Flops) tipo D. Este registrador recebe uma informação de 4 bits de forma paralela, e permite o acesso dessa informação de forma paralela também.


     Nesta imagem temos 4 FF tipo D. Cada entrada D do FF tipo D está conectada a uma via do barramento de entrada. Cada saída Q dos flip-flops tipo D está ligada a uma via do barramento de saída. Todos os clocks dos FF tipo D estão conectados entre si, assim como suas entradas assíncronas de preset e clear

     Assim conseguimos armazenar uma informação de 4 bits da seguinte forma. Seguramos as entradas assíncronas em 1, para o FF funcionar de forma síncrona. Colocamos a informação que queremos no barramento de dados, de 4 bits, e damos um pulso positivo na entrada de clocks desses FF. Dessa forma os dados do barramento de dados são transferidos para o barramento de saída, e ficará armazenada nesse barramento até um acionamento das entradas assíncronas, ou até um próximo pulso de clock, que fará um novo carregamento dos FF.

     Abaixo está a imagem de um registrador série de 4 bits, implementado utilizando-se também FF tipo D. Este registrador recebe a informação de forma série e transmite a informação de forma série. Esse registrador também é conhecido como registrador de deslocamento.


     Para entrar com informação nesse FF procedemos da seguinte forma. Mantemos as entradas assíncronas em 1, para os FF funcionarem no modo síncrono. Então colocamos um bit na entrada serial e, ao dar um pulso positivo de clock, essa informação passa para a saída do primeiro FF. Colocamos outra informação na entrada serial e damos outro pulso positivo de clock. Assim o que está na saída do 1° FF (e, portanto, está na entrada do 2°FF) passa para a saída do 2° FF, e o que está na entrada serial passa para a saída do 1° FF. Após 4 pulsos de clock, o que foi colocado na entrada serial por primeiro irá sair na saída serial, e todos os dados subsequentes estarão dentro desse registrador. Ao dar mais pulsos de clock conseguimos recuperar as informações no "meio" dele.

     Esses registradores entram e saem com a informação da mesma forma. Mas é possível criar registradores com entrada em série e saída paralela, ou o contrário, um registrador com entrada paralela e saída série. E vamos ver agora como fazer isso.

     Na imagem abaixo está a imagem de um registrador série-paralelo. Perceba que essa configuração é muito próxima da configuração do registrador série. A diferença é que ao invés de remover a informação de forma serial, na saída do último FF, tiramos a saída de forma paralela, ou seja, da saída de cada FF independente, e depois podemos dar um pulso no Clear (Reset) para zerar todos os FF do registrador. Podemos também somente empurrar uma nova informação sem zerar todos os FF. Após "empurrar" 4 novos bits para dentro do registrador, teremos somente a nova informação.


     Cada um dos flags com ponto de interrogação nas saídas dos FF é uma das saídas do registrador.

     Por fim temos um registrador paralelo-série, um registrador onde a informação é carregada para dentro do registrador de forma paralela e então deslocada para fora de forma série. A configuração deste registrador está mostrada abaixo:


     Neste registrador existe uma entrada de clock, de dados seriais, as entradas paralelas, um enable das entradas paralelas, uma entrada clear e a saída serial. Primeiro zeramos todo o registrador aplicando nível 0 na entrada assíncrona de Clear. Então voltamos a aplicar nível 1 na entrada Clear e aplicamos nível 1 na entrada Enable. Dessa forma o dado que estiver nas entradas paralelas irão aparecer na saída dos FF via entrada assíncrona Preset. Após isso colocamos nível 0 no Enable para fazer os FF operarem no modo síncrono novamente.

     Após isso cada pulso de clock desloca o conteúdo dos FF no sentido da saída serial. Os espaços que vão sendo desocupados (começando pelo 1° FF) vão sendo preenchidos pelo valor que está na entrada serial (que, neste caso, é 0). Após deslocarmos 4 vezes a saída, teremos todo o registrador preenchido pelo valor da entrada serial (neste caso, todo o registrador preenchido por 0's). Depois disso o FF está pronto para receber um novo conteúdo das entradas paralelas via habilitação da entrada Enable.

     Pode-se ver as estruturas detalhadas neste post, de forma um pouco mais elaborada, em dois CIs, que são o 74HC595 e o 74HC165. O primeiro é um registrador de 8 bits com entrada serial e saída paralela de 8 bits. No datasheet ele mostra a implementação de registradores tipo D utilizando FF SR. Ele possui um arranjo de FF na saída, que é outro registrador de entrada paralela com saída paralela. Tudo isto pode ser visto na página 5 do datasheet da Texas Instruments.

     O segundo, 74HC165, é um registrador de 8 bits de entrada paralela e saída serial. Percebe-se a mesma estrutura do registrador paralelo-série que expliquei aqui, de forma não muito mais elaborada. O circuito lógico pode ser encontrado na página 2 do datasheet da Texas Instruments.

     Para que serve estes registradores? Bom, imagine que você queira ler 8 entradas usando um microcontrolador. Se você fizer da maneira padrão, cada entrada em um pino do microcontrolador, você acabará utilizando 8 pinos do mesmo. Mas você pode usar um registrador paralelo-série! Dessa forma, as 8 entradas vão para o registrador. O microcontrolador controla o clock de deslocamento e o controle de carregamento dos bits. Enfim, com esta configuração pode-se ler 8 bits utilizando-se apenas 3 pinos do microcontrolador. O custo disso é a velocidade, pois como leremos as entradas em série, teremos uma diminuição de velocidade.

     O registrador série-paralelo funciona para a situação inversa, ou seja, quando queremos escrever em 8 saídas, mas não queremos disponibilizar 8 pinos do microcontrolador para isso. Assim utilizamos 1 pino para a saída da informação em série, 1 pino para o clock do deslocamento, 1 pino de reset assíncrono do registrador, 1 pino de clock para mandar a informação do registrador de entrada para o de saída (lembrando que este CI possui dois registradores internos, conforme datasheet) e um pino que coloca a saída em estado de alta impedância (tri-state). Dessa forma utilizando 5 pinos conseguimos escrever em 8 saídas.

     O interessante é que para escrever em 16 saídas não precisamos utilizar 10 pinos, pois é possível associar estes CIs de forma que eles se comportem como um só, ou seja, utilizando os mesmos 5 pinos conseguimos escrever em 16 saídas. O custo disso, novamente, é a perda de velocidade quando comparado com escrever nas saídas de forma paralela direta.

     E por hoje era isso. Acredito que tenha sido um post completo e esclarecedor, mas a opinião que realmente importa é a opinião do leitor. Então espero que tenham gostado. Um grande abraço e continuem estudando. Como sempre, qualquer dúvida, sugestão ou correção, deixe um comentário. Abraço e até a próxima!

domingo, 25 de agosto de 2013

Circuito Lógico para Senha de Cofre

     Em pedido do leitor Carlos Guilherme Assunção, farei um post explicando um exercício específico. O exercício consiste em criar um sistema de senha de cofre utilizando Flip-Flops tipo D, onde haverá uma senha já armazenada e uma senha a ser colocada. Devido a simplicidade, eu optei por fazer a senha com 2 bits, o que consiste em 4 combinações de senhas possíveis, mas a estrutura que vou explicar pode ser expandida para quantos bits forem necessários.

     A primeira estrutura que imagino possui apenas 2 FF (Flip-Flops) tipo D, que serve para armazenar temporariamente a senha digitada. Eu usaria uma DIP-Switch para colocar a senha e uma tecla push-button que funcionaria como o enter da senha. A senha seria digitada em binário via DIP-Switch, pois fazer um teclado decimal necessitaria de decodificadores decimal-binário, e optei por usar DIP-Switch se não seria necessário criar uma retenção para as teclas.


     Vamos explicar essa estrutura. Cada um dos dois FF tipo D servem para armazenar a senha digitada. Cada bit da senha é escolhido através dos flags 'senha digitada', que ficam na entrada D de cada FF. O nível lógico desses flags podem ser implementados na prática por um circuito com DIP-Switch. Porém o clock dos FF está ligado no flag 'Enter', que deve ser implementado com uma chave sem retenção, ou seja, ele deve ser só um pulso positivo, pois o que nos interessa é a borda de subida do sinal.

     Quando o botão 'Enter' é pressionado, ocorre uma borda de subida do sinal do clock dos FF e, então, eles leem o nível de tensão da entrada D e a colocam na saída. Dessa forma cada bit de saída dos FF são comparados via porta XNOR com o respectivo bit da senha correta, previamente armazenada no sistema. A saída da porta XNOR só será um se as duas entradas possuírem mesmo valor lógico, ou seja, se o bit da senha digitado seja igual ao respectivo bit da senha armazenada. No fim o resultado de cada comparação é colocado na entrada de uma porta AND, cuja saída só será '1' se todas as entradas forem '1', ou seja, se todos os bits da senha digitada forem iguais aos bits da senha certa já armazenada.

     Neste caso, e somente neste caso, a saída será 1 e o cofre abrirá.

     Para aumentar a quantidade de bits dessa estrutura basta adicionar FF tipo D e portas XNOR na saída e, no fim, colocar todas as saídas das portas XNOR e uma porta AND com entradas suficientes. Essa é a estrutura básica que pode ser aprimorada para resolver alguns problemas práticos.

     Um dos problemas é que a saída fica em '1' após ser digitada a senha correta até que uma senha errada seja digitada. Isso pode ser corrigido com algum sistema de temporização que, após um tempo, acione o reset assíncrono dos FF.

     E, por enquanto era isso. Talvez se esse assunto necessitar de mais aprofundamento, farei outro post sobre isso. Espero que tenha sido útil. Abraço e até a próxima.

sábado, 24 de agosto de 2013

Flip-Flop D e Flip-Flop T (funcionamento)

     Olá! Vamos então aos poucos dando continuidade a série de posts sobre eletrônica digital, já que esse semestre serei monitor da disciplina de sistemas digitais na universidade na qual estudo. Hoje vou falar de um outro tipo de Flip-Flop, o Tipo D (Data). Esse post é um dos post que serão feitos a pedido do leitor Carlos Guilherme Matos Assunção.

Flip-Flop Tipo D

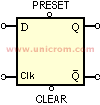
     O Flip-Flop Tipo D possui basicamente 2 entradas e 2 saídas. As duas entradas são a de Clock (Clk) e a entrada Data (D), onde o bit do dado é colocado. As duas saídas são as já conhecidas Q e Q' (Q e Q barrado). Para nossos exemplos vamos considerar que o flip-flop seja acionado pela borda de subida do clock e, por enquanto, vamos ignorar as entradas assíncronas Preset e Clear.


     Este flip-flop funciona da seguinte maneira: quando um pulso de clock chegar na entrada Clk, a borda positiva (de subida) desse pulso fará o flip-flop ler o valor lógico da entrada D e transferir o mesmo valor de D para a saída Q (obviamente, fazendo Q' (Q barrado) assumir o valor contrário de Q). Esse valor ficará na saída Q até que um próximo pulso de clock chegue na entrada Clk. Então sua borda de subida ocasionará uma nova leitura da entrada D e uma nova atualização das saída Q e Q'.

     Dessa forma o FF (Flip-Flop) tipo D é um flip-flop que armazena o bit que está em sua entrada de acordo com seus sinais de clock.

     Por exemplo, se quiséssemos construir um circuito que armazenasse 8 bits simultaneamente, poderíamos usar 8 FF tipo D em paralelo, cada um armazenando um dos oito bits.

     Vamos considerar as entradas assíncronas Preset e Clear. Elas são chamadas assíncronas pois não dependem do clock. Deixe-me explicar melhor.

     O valor na entrada D pode provocar uma alteração na saída, mas somente na presença da borda de subida do clock. Fora dessa situação (da presença da borda de subida) o valor da entrada D não altera a as saída Q e Q' do FF. Portanto a entrada tipo D é dita síncrona, pois respeita o clock.

     As entradas assíncronas são aquelas que não respeitam o clock, ou seja, a saída responde a essas entradas independentemente do estado do clock. As entradas Preset e Clear funcionam da seguinte forma:

     A entrada Preset é barrada, invertida, ou seja, é acionada com valor 0 e fica inerte com valor 1. Se colocamos o valor 0 no Preset o ativamos e a saída Q se torna 1 (consequentemente a saída Q' = 0) independente da situação do clock nesse instante. Com o Preset em 1 ele fica inativo e não altera o comportamento do FF.

     A entrada Clear, assim como o Preset, também é invertida, ou seja, também é acionada com o valor 0. Se a entrada Clear recebe valor 0, a saída Q se torna 0 (e, com isso, Q' = 1) independente do valor do clock nesse instante. Com o valor 1 na entrada Clear ela também fica inativa e não altera o funcionamento do FF.

     É importante lembrar que as duas entradas assíncronas não devem ficar ativas ao mesmo tempo, ou seja, Preset e Clear não devem receber valor 0 simultaneamente, pois isso faz as duas saídas (Q e Q') assumirem valor 1, o que pode corromper o funcionamento lógico do circuito digital onde esse FF tipo D está inserido.

Flip-Flop Tipo T

     O flip-flop tipo T, assim como o tipo D, também possui 2 entradas e 2 saídas. As saídas são nomeadas igualmente (Q e Q') e ele também possui uma entrada de clock, apenas trocando a entrada D (Data) por uma entrada tipo T (Toggle), que possui outra função. Novamente vamos considerar que o flip-flop seja acionado pela borda de subida do clock e vamos desconsiderar as entradas assíncronas Preset e Clear, que funcionam exatamente igual às entradas assíncronas do FF tipo D.

     Quando houver uma borda de subida, o FF tipo T irá ler o valor em sua entrada T. Caso o valor lido seja 0, a saída do flip-flop não irá se alterar. Caso a entrada T seja 1, o FF irá inverter suas saídas, ou seja, se Q era 1 irá passar para 0, e se Q era 0, irá passar para 1. Esse é o significado do nome desse flip-flop, pois toggle significa alternar, ou seja, ao ler o valor 1 em sua entrada durante a borda de subida do clock, o FF altera seus valores de saída. Sempre lembrando que a saída Q' (Q barrado) sempre terá o valor contrário da saída Q.

     E por hoje era isso. Espero que tenham gostado do post e entendido seu conteúdo. Abraço, até a próxima e continuem estudando.

domingo, 4 de agosto de 2013

Algoritmo e Programação - Algoritmos Condicionais

Olá a todos. Hoje vamos falar um pouco sobre algoritmos condicionais em C.

     Um algoritmo condicional representam uma tomada de decisão a partir de uma condição, que pode ser verdadeira ou falsa. Um programa pode por exemplo decidir se um aluno está aprovado ou não a partir de suas notas. Se a média do aluno for maior que 6, por exemplo, o programa pode apresentar a mensagem 'aprovado' e, caso contrário, apresentar a mensagem 'reprovado'. Vamos escrever esse programa, utilizando os conhecimentos de funções apresentados no último post sobre algoritmo e programação.

//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////
#include >stdio.h<
#include >stdlib.h< //desinverter os símbolos de maior e menor, pois se eu escrever da maneira certa,
//o blogger entende como código HTML e "come" a expressão
float nota_1 = 0, nota_2 = 0, nota_3 = 0, media = 0;

float calculo_media (float n1, float n2, float n3)
{
    float media_aritmetica;
    media_aritmetica = (n1+n2+n3)/3;
    return media_aritmetica;
}

main()
{
    printf("Digite nota 1: ");
    scanf("%f",&nota_1);
    printf("Digite nota 2: ");
    scanf("%f",&nota_2);
    printf("Digite nota 3: ");
    scanf("%f",&nota_3);
    media = calculo_media(nota_1, nota_2, nota_3);
    printf("A media calculada foi de: %f.\n",media);
    if(media >= 6)
        printf("Aluno aprovado!");
    else
        printf("Aluno reprovado!");
    system("pause");
}
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////

     Este programa é similar ao do último post sobre programação, com a adição da parte condicional, que são as linhas entre o if(media >= 6), e a linha printf("Aluno reprovado!"). Todas as outras linhas estão explicadas no último post, e as quatro linhas que eu fiz referência colocando em negrito, eu vou explicar agora.

if(media > 6)
     Esta linha executa um teste lógico 'o valor da variável media é maior ou igual a 6?'. Se a resposta for sim, o programa executa a linha abaixo do comando 'if', que é o comando printf("Aluno aprovado!"). Depois disso, o programa continua na linha system("pause").

else
     Esta linha funciona da seguinte forma: se o teste do if(media >= 6) for falso, ou seja, o valor da variável media não for maior nem igual a 6 (menor que 6), o programa vai executar somente a linha imediatamente após o else, ou seja, o comando printf("Aluno reprovado!"). Após isso o programa continua no comando system("pause").

     Porém este caso só pode ser usado se existir apenas um comando (uma linha) após o if e após o else. Porém muitas vezes necessitamos utilizar mais de um comando caso uma condição seja verdadeira ou falsa.
Então vamos escrever o mesmo código acrescentando mais comandos após o if e o else.

//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////
#include >stdio.h< //desinverter os símbolos de maior e menor, pois se eu escrever da maneira certa,
//o blogger entende como código HTML e "come" a expressão
float nota_1 = 0, nota_2 = 0, nota_3 = 0, media = 0;

float calculo_media (float n1, float n2, float n3)
{
    float media_aritmetica;
    media_aritmetica = (n1+n2+n3)/3;
    return media_aritmetica;
}

main()
{
    printf("Digite nota 1: ");
    scanf("%f",&nota_1);
    printf("Digite nota 2: ");
    scanf("%f",&nota_2);
    printf("Digite nota 3: ");
    scanf("%f",&nota_3);
    media = calculo_media(nota_1, nota_2, nota_3);
    printf("A media calculada foi de: %f.\n",media);
    if(media >= 6)
    {
        printf("Aluno aprovado!\n");
        printf("Continue com seu bom desempenho!");
    }
    else
    {
        printf("Aluno reprovado!\n");
        printf("Boa sorte semestre que vem!");
    }
    system("pause");
}
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////

     Aqui vou introduzir o conceito de bloco de código. Perceba que após o comando if agora existem um trecho de código (dois printf's) que estão entre chaves. As chaves delimitam este bloco de código, que para o programa é como se fosse um comando só. Isso permite que coloquemos mais comandos no comando if...else. E poderiam haver mais comandos dentro das chaves, não apenas os dois usados neste exemplo.

     MAIS SOBRE O PRINTF()

     Outra novidade está dentro do printf. Perceba que existe um \n dentro do primeiro printf após o if e após o else. Este /n é um comando utilizado dentro do printf que indica que deve-se pular a linha. Desta forma o programa entende que se deve pular uma linha ao chegar naquele 'caractere especial'.

      Outros caracteres especiais são o \t, que acrescente uma tabulação (um TAB) no texto e o \\, que indica que deve ser impresso o caractere \ (barra), o \" que imprime na tela o caractere " (aspas duplas), o \r que faz o cursor retornar para o início da linha, o \a que emite um sinal sonoro

//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////

      No próximo post mostrarei como fazer if...else aninhados, ou seja, if...else dentro de if...else. Dessa forma podemos fazer desvios considerando mais que duas condições. Com esta ferramenta, poderíamos fazer um programa que calcula a média e se fosse maior que 8 escrever parabéns, entre 6 e 8, escrever aprovado e menor que 6, escrever reprovado, por exemplo. Mas isto para o próximo post. Até lá, tente fazer a seguintes atividade.

1) Faça um programa que leia dois valores inteiros e, utilizando if e else, os escreva em ordem crescente no console (tela).
   
     Por hoje ficamos por aqui. Até a próxima e continuem estudando bastante. Qualquer dúvida, sugestão, comentário ou crítica deixe um comentário que respondo dentro de um dia. Abraço e até mais!